別讓 AI 成為失控吃錢怪!cacaFly 吳振和:企業要讓 AI 真正可信可用,關鍵在「駕馭工程」與資料治理
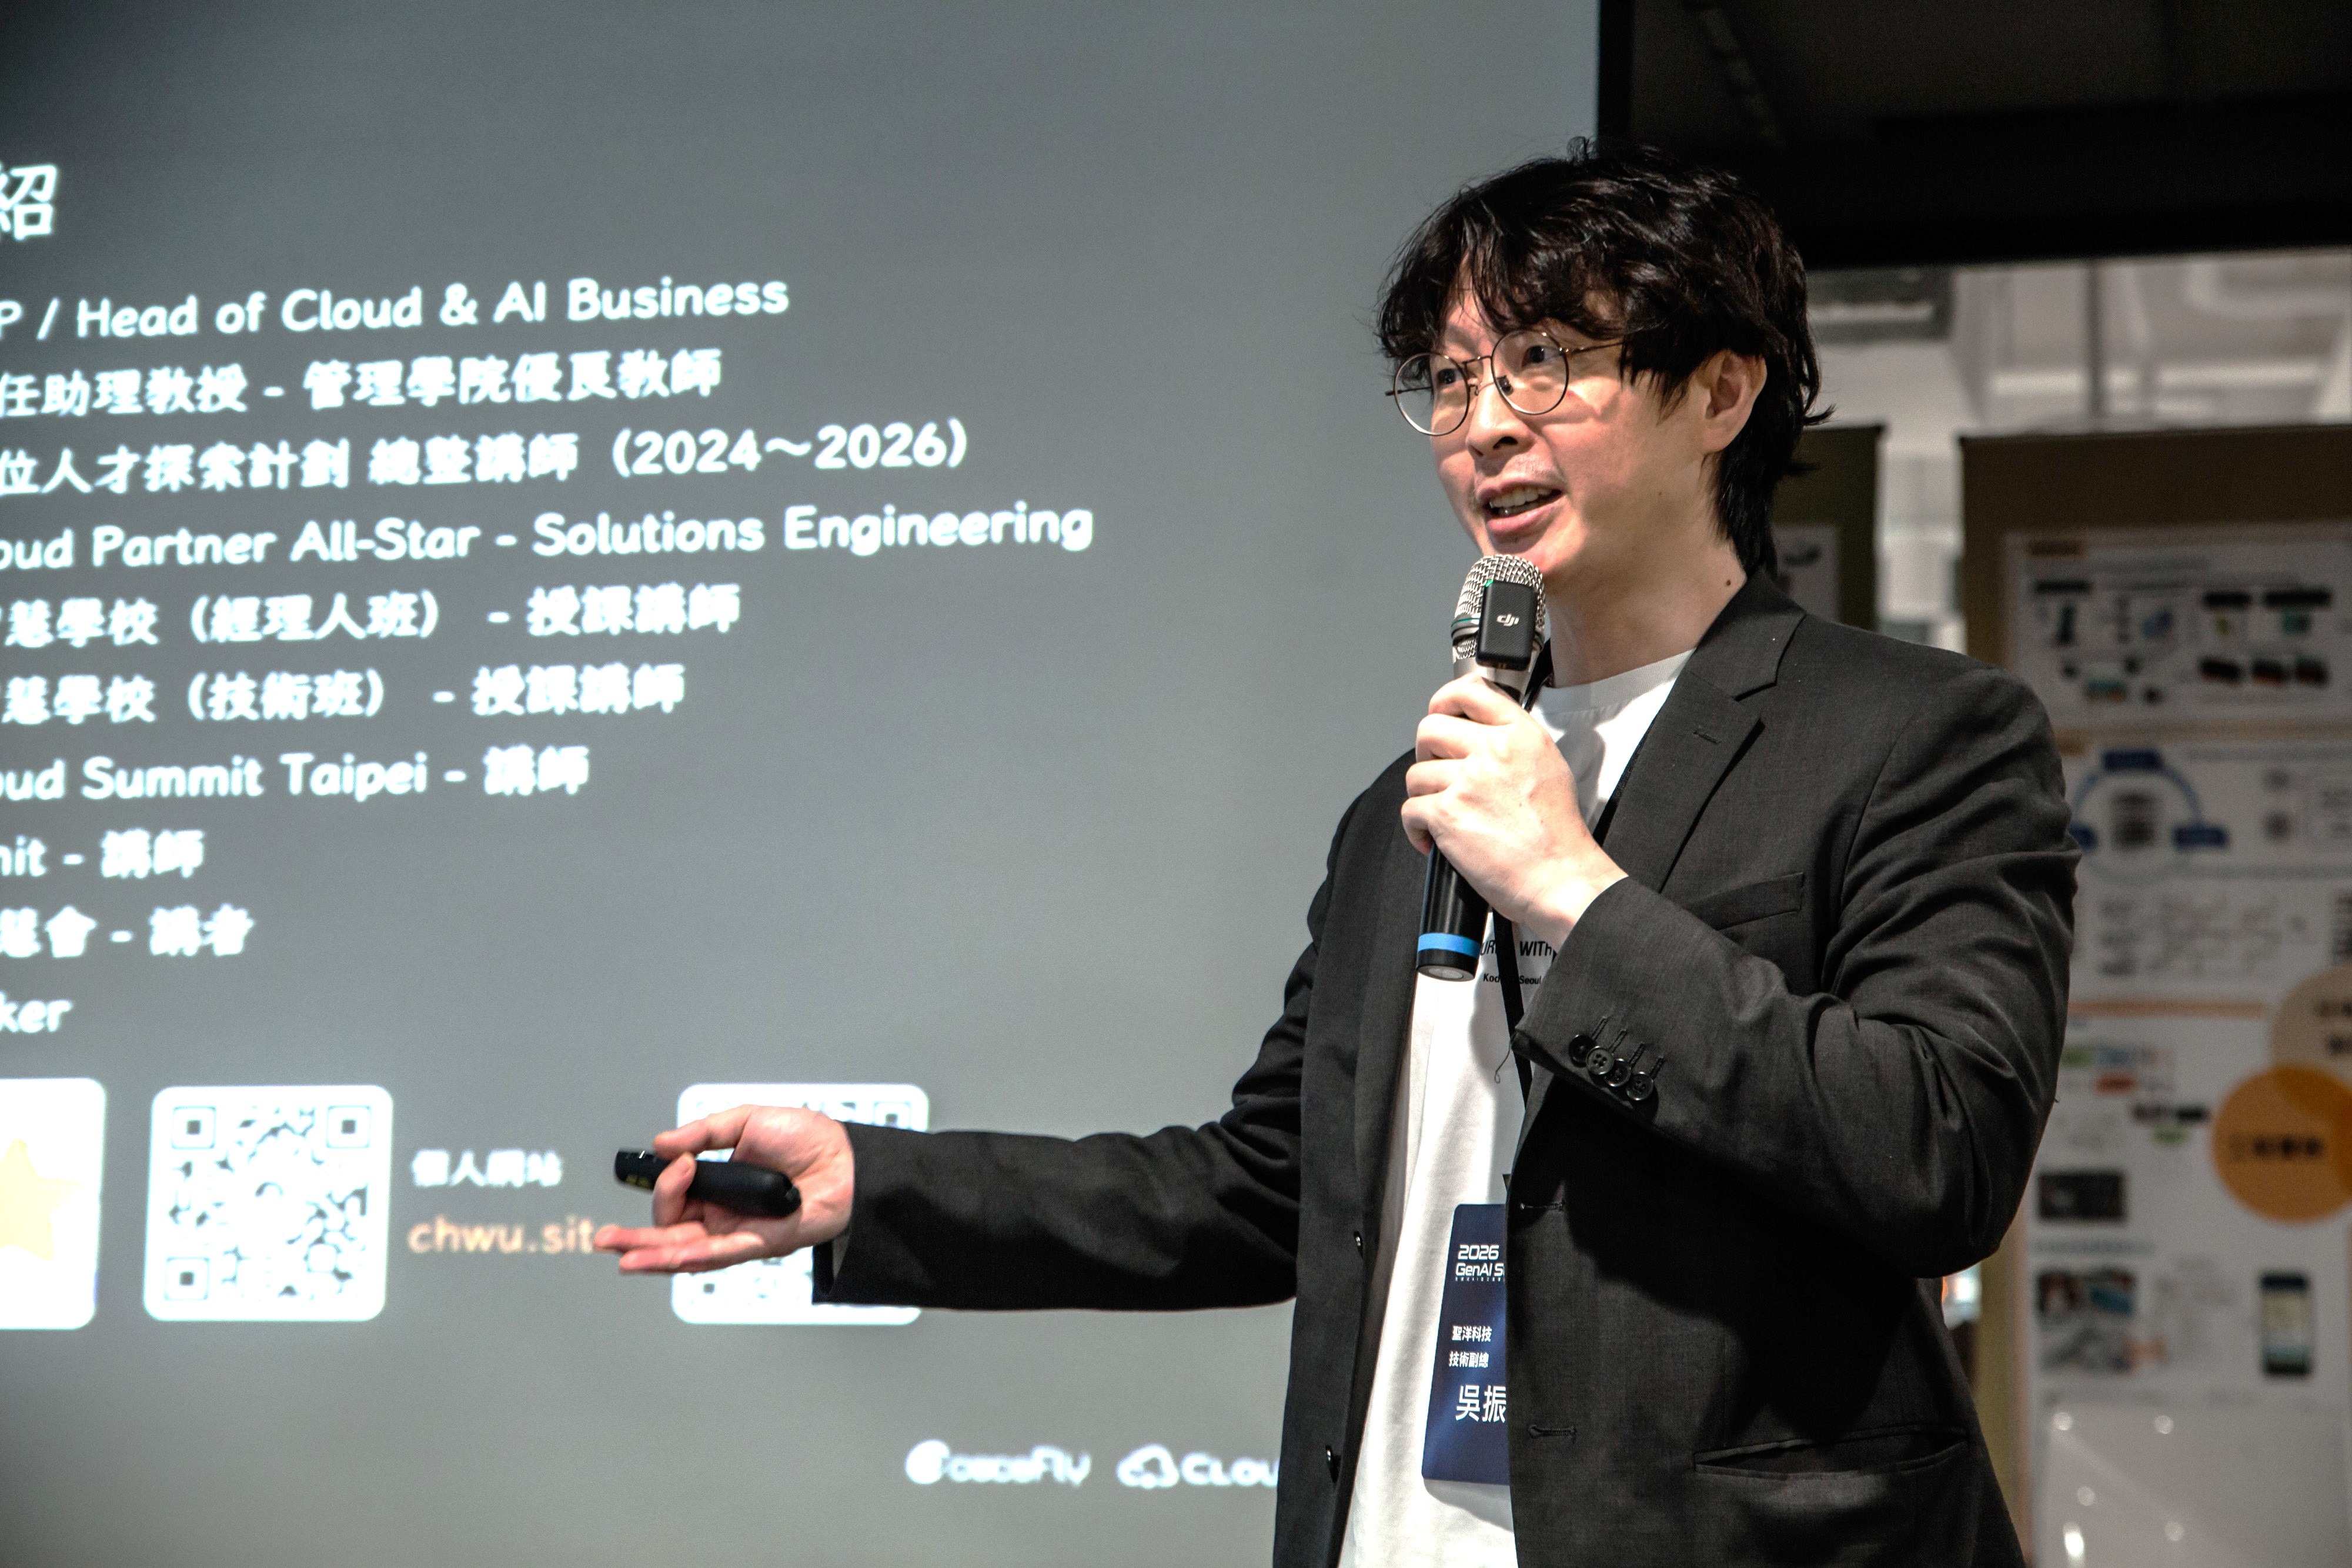
生成式 AI 時代來臨,企業應用AI正從「買帳號試用」邁向「真正幫公司做事」的關鍵轉折點。10月27日,GenAI Stars 選拔與深度輔導計畫舉辦前瞻技術論壇,由執行單位台大智活中心邀請台灣數位行銷與雲端解決方案先行者cacaFly的雲端與AI事業副總、台科大兼任助理教授吳振和,以「從Agent工程走向AI時代的企業級Harness Engineering」為題,分享大型語言模型在企業內部安全落地的實務經驗。 吳振和從模型的推理與工具使用能力出發,進一步說明 AI Agent 如何透過反覆修正與上下文管理完成任務,並指出企業必須同步建立資料治理、語意層與評估機制,才能打造可持續運作的 AI 工作系統。
Harness:模型之外的控制,決定 Agent 能不能上線 吳振和引用 Anthropic 的核心公式「Agent = Model + Harness」強調,強大的模型只是引擎,唯有加上完善的駕馭工程(Harness),Agent 才具備商轉條件。在企業環境中,這代表不能只做 AI 程式開發,而須建立完整的管控機制。 完整的企業級Harness架構,包含集中式Agent註冊平台與身分權限控管(IAM)、安全存取入口、沙盒(Sandbox)運作環境,以及Token成本監控與審核日誌。他也提醒,企業導入AI時應跳脫傳統系統整合(SI)的固定規格思維,先透過概念驗證(POC)收斂問題邊界,釐清哪些任務適合由AI處理、哪些仍須保留人工與彈性設計,才能讓架構穩健落地。 image.png911.03 KBData Harness:先找對資料、統一定義,AI才答得準 吳振和坦言,企業導入AI最大的天花板往往在資料。企業資料常散落於NAS、雲端硬碟與各式IT系統,且多為非結構化檔案;更棘手的是,不同部門對同一指標(例如「高價值客戶」)的定義可能存在分歧,若直接交給 AI 處理,反而容易放大資料品質問題。 因此,企業應建立語意層(Semantic Layer),統一度量公式、資料字典與業務規則(Business Rules),並可進一步結合知識圖譜(Knowledge Graph)與 GraphRAG技術,定義資料血緣與實體關聯。吳振和分享,相關實測可將 SQL 查詢錯誤率大幅降低67%,答對率提升至原本的3倍,表現優於容易夾帶雜訊的傳統 Document RAG。
評估與變更:用黃金題持續驗證,規則改了就重跑 「能跑,不代表結果正確。」吳振和提醒,企業不應僅憑個人「體感測試」判斷 AI表現。當資料欄位或商業規則變動時,AI的回答邏輯可能悄然走樣,因此必須建立長期評估與驗證機制。 健全的驗證機制包含三大關鍵:首先,建立黃金資料集(Golden Dataset),蒐集真實問題並依領域與難度分類;其次,由專家進行標註與審核,並納入惡意指令注入(Prompt Injection)等資安防護測試;最後,實施自動化迴歸測試(Regression Testing),並指定業務單位的資料負責人(Data Owner),確保規則調整後能即時重跑驗證,維持回答品質。 image.png953.45 KB與創業者共勉:跨部門協同打造企業級 AI 護欄 吳振和在演講尾聲期勉現場所有創業團隊,企業資料治理非單一 AI 開發者或 IT 部門的責任;每一個可信任的答案,都是由資料、語意、模型風險與回饋共同完成。因此,企業需要業務端團隊,包括業務負責人、領域資料治理人員、產品開發與營運團隊,以及技術端團隊,包括資安、AI 工程與資料工程人員,共同參與資料盤點、規則定義與風險控管。他也鼓勵現場夥伴未來持續保持交流,共同打造穩定、安全且真正釋放商業價值的企業級 AI 應用。